在 AI 应用落地过程中,我们常常需要将用户和 AI 的对话以“完整上下文”的形式持久化到数据库中。但当 AI 回复非常长,甚至接近上万字时,传统的单条消息保存机制就会出问题。
在本篇文章中,我将深入讲解一次实际项目中对 对话持久化+SSE流式响应机制 的全面升级,核心围绕 SeekController.java 控制器类改造展开,对比旧代码与新方案,解释其设计思路、实现细节和优化点。
场景背景:
假设你正在开发一个 AI 小学辅导应用,用户与 AI 进行对话,后端通过 SSE(Server-Sent Events)协议流式返回 AI 回复。同时你需要将所有对话保存在数据库中,供后续查看和继续。
原始版本的逻辑存在以下问题:
❌ AI回复过长,数据库字段溢出;
❌ 保存逻辑未考虑拆分或异常;
❌ 用户消息也可能过长,直接保存风险大;
❌ SSE流式输出与持久化耦合度过高;
❌ 报错无提示,仅日志记录。
改造目标:
- 使用分块机制安全持久化超长消息;
- 提供中英文断句逻辑,尽可能自然地分段;
- 保留流式体验,同时异步、稳健保存数据;
- 出错时降级处理,保留关键信息;
- 增强可维护性和日志追踪能力。
新旧对比:设计与核心区别一览
| 功能点 | 原实现(假设) | 新实现(本代码) |
|---|---|---|
| SSE流式 | 可能返回整段数据 | 基于 DeepSeek 接口流式返回 JSON |
| 持久化 | 整体写入,一次提交 | 分块处理、格式化保存 |
| 长文本处理 | 可能直接截断 | 中文标点 + 段落智能断点 |
| 错误处理 | 仅 try-catch | 加入错误消息保存入库 |
| 用户体验 | 容易失败不提示 | “内容被截断”“部分消息”明确反馈 |
核心升级一:AI回复和用户消息智能分块保存
private static final int MAX_DB_CHUNK_LENGTH = 16000;
private static final int PREFERRED_CHUNK_LENGTH = 8000;
系统限制数据库字段为 16000 字符以内,为避免过长内容保存失败,我们:
- 定义“首选分块长度”(8000)和“最大字段长度”;
- 优先尝试在中文句号(。)、感叹号、问号等自然断句处断开;
- 找不到就退而求其次,在段落分隔符(\n\n)断开;
- 保存时附加头部说明和结尾标注,如 [第1块/共3块];
- 超出字段限制则尾部加 "[内容被截断]" 明确提示。
分块格式如下:
[第1块/共2块] 这是一段很长很长的回复内容,适合分块保存。

[此为分块消息的一部分]
核心升级二:AI 响应内容通过 SSE 流式返回 + 动态拼接
RealEventSource realEventSource = new RealEventSource(request, new EventSourceListener() {
    @Override
    public void onEvent(EventSource eventSource, String id, String type, String data) {
        if (DONE.equals(data)) return;

        String content = getContent(data);
        if (content != null) {
            // 累积回复
            aiResponseRef.set(aiResponseRef.get() + content);

            // SSE 推送
            pw.write("data:" + JsonUtils.convertObj2Json(new ContentDto(content)) + "\n\n");
            pw.flush();
        }
    }
});
核心亮点:
- DeepSeek 的接口通过 SSE 返回 delta 内容;
- 每次内容片段都会立即返回前端,极大提升响应速度和流畅性;
- 同时我们使用 AtomicReference 变量拼接全量回复,供后续入库。
核心升级三:用户消息也不再“盲目乐观”
别只考虑 AI 长文本,用户输入如果是整段阅读理解、文章、作文题目,也可能超长!
private void saveUserMessage(Integer conversationId, String userContent) {
    List<String> chunks = splitContentIntoChunks(userContent);

    for (int i = 0; i < chunks.size(); i++) {
        String chunkContent = formatChunkContent(chunks.get(i), i, chunks.size());
        if (chunkContent.length() > MAX_DB_CHUNK_LENGTH) {
            chunkContent = chunkContent.substring(0, MAX_DB_CHUNK_LENGTH - 100) + "...[内容被截断]";
        }

        Message userMsg = new Message();
        userMsg.setConversationId(conversationId);
        userMsg.setSenderType(Message.SenderType.USER);
        userMsg.setContent(chunkContent);
        messageService.add(userMsg);
    }
}
用户输入同样 优先尝试智能分段 + 分块保存,并在失败时记录错误提示。
核心升级四:AI系统消息加入“角色注入”
为了让 AI 更符合目标受众(小学生),我们默认在每次对话中插入一条系统 prompt:
systemMessage.put("content", "你是一个经验丰富的小学学习辅导 AI 助手...");
这段 prompt 会 始终被添加为上下文第一条消息,确保风格和角色固定一致。
技术细节亮点汇总
| 技术点 | 用法说明 |
|---|---|
| SSE协议 | 使用 EventSource 和 RealEventSource 实现流式对话 |
| OkHttp | 使用 OkHttp 发送带事件监听器的 POST 请求 |
| CountDownLatch | 阻塞主线程直到 SSE 结束 |
| Jackson ObjectMapper | 精准地处理 JsonNode 和字符串互转 |
| 分块处理 | 断句处理中文标点、英文标点、段落符 |
| 分块标注 | 提供块序号、块总数、尾注辅助前端识别 |
| 降级容错 | 保存失败时 fallback 记录错误提示消息 |
用户体验提升细节
- AI语气风格:符合儿童认知水平和心理预期;
- 前端流畅呈现:每条回复几乎“实时可见”;
- 对话记录清晰分层:块头/块尾标注简洁明确;
- 出错时不报错白屏,保留重要提示信息。
小结与反思
本次升级看似只是对“长文本保存”的功能增强,但背后牵涉到了数据结构设计、AI接口集成、用户体验控制、系统健壮性等多个维度的系统性思考。
最关键的不是“写对代码”,而是能预判潜在问题,并留出足够冗余空间处理边界异常。
结语
如果你也在构建 AI 应用系统,强烈建议你:
- 使用 流式返回机制 提升响应体验;
- 加入 分块策略 处理高可变长度的输入/输出;
- 异常可见化,让错误被看到、被记录、被挽救;
- 提前考虑 前后端协作约定,如 chunk 标注语法。
希望本篇文章能为你带来实用灵感!
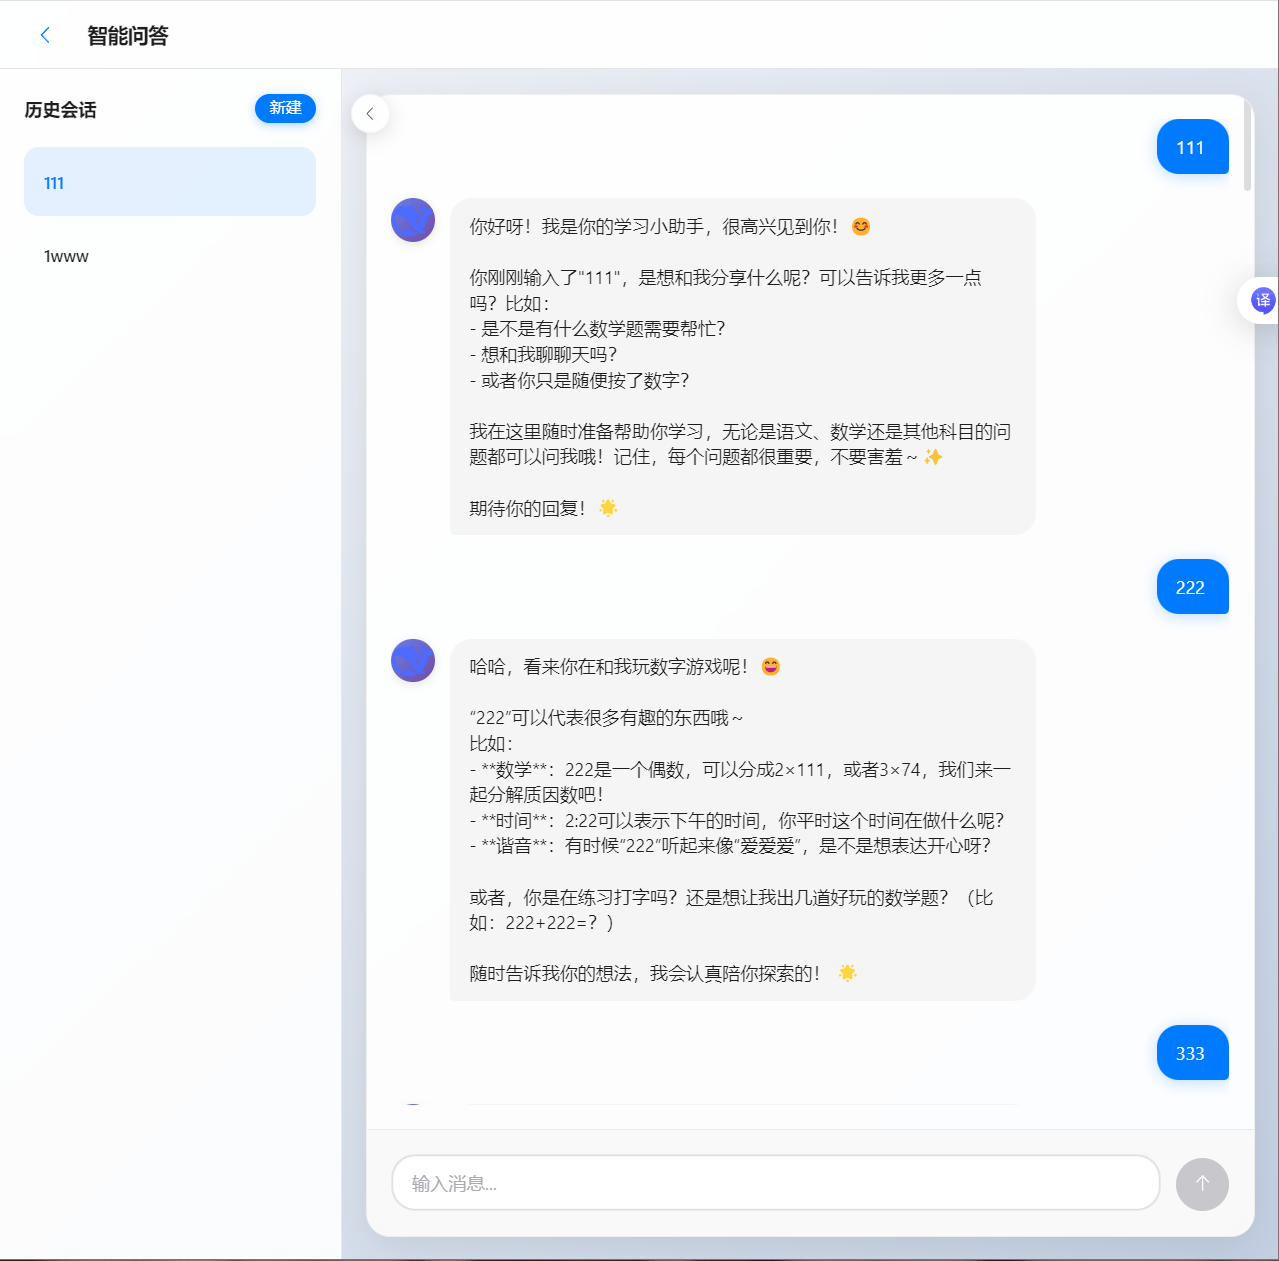
效果展示: