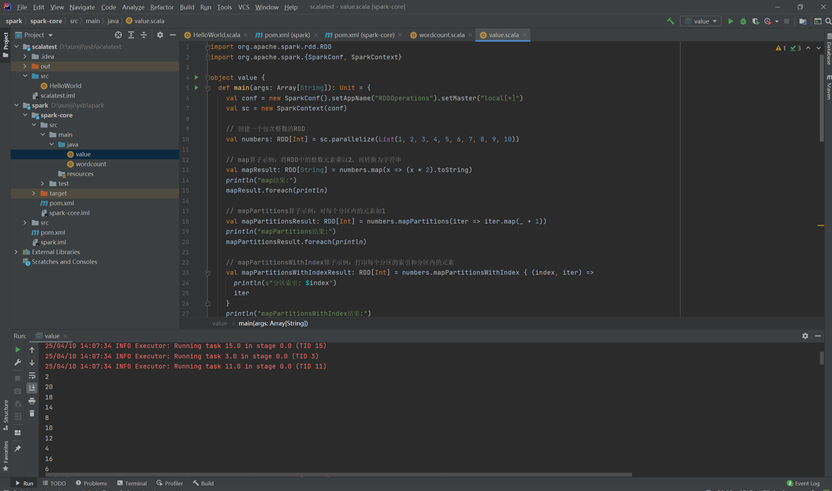
1. map
功能:将处理的数据逐条进行映射转换,可以是类型的转换或值的转换。
函数签名:def mapU: ClassTag](f: T => U): RDD[U]
特点:逐个元素处理,性能较低,但易于理解和使用。示例:将RDD中的整数元素乘以2,再转换为字符串。
2. mapPartitions
功能:以分区为单位处理数据,可以对数据进行任意处理,包括过滤。
函数签名:def mapPartitions[U: ClassTag](f: IteratorT] => Iterator[U], preservesPartitioning: Boolean = false): RDD[U]
特点:批处理操作,性能较高,但可能占用较多内存,有内存溢出风险。
与map的区别:map是逐元素处理,mapPartitions是分区级批处理;map不会改变数据数量,而mapPartitions可以增加或减少数据。
3. mapPartitionsWithIndex
功能:以分区为单位处理数据,同时可以获取当前分区索引。
函数签名:def mapPartitionsWithIndex[U: ClassTag](f: (Int, Iterator[T]) => IteratorU], preservesPartitioning: Boolean = false): RDDU]
特点:适用于需要分区索引的场景,如分区特定的数据处理逻辑。
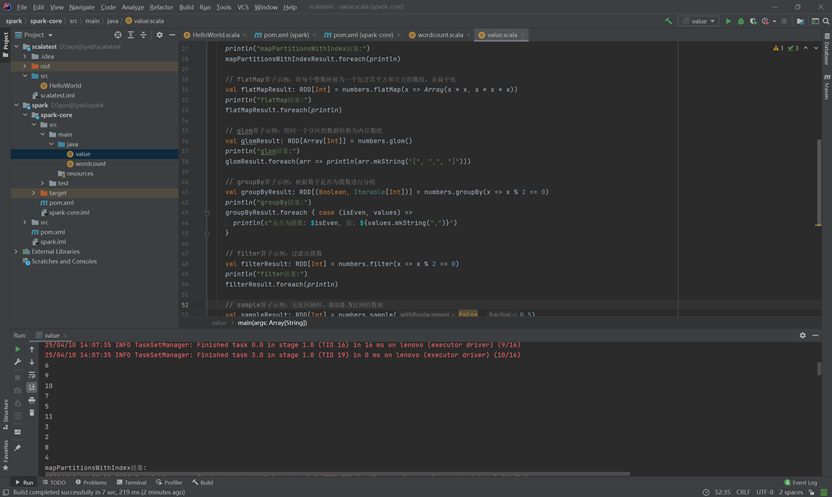
4. flatMap
功能:将处理的数据进行扁平化后再进行映射处理。
函数签名:def flatMap[U: ClassTag](f: T => TraversableOnceU]): RDDU]
特点:适用于需要将每个输入元素映射为一个集合,并将这些集合合并为一个大数据集的场景。
与map的区别:map将每个输入元素映射为一个新对象,而flatMap将每个输入元素映射为一个集合,并将这些集合合并。
5. glom
功能:将同一个分区的数据直接转换为相同类型的内存数组进行处理。
函数签名:def glom(): RDD[Array[T]]
特点:适用于需要以分区为单位处理数据的场景,如分区级别的数据聚合。
6. groupBy
功能:将数据根据指定的规则进行分组,数据会被打乱重新组合,涉及shuffle操作。
函数签名:def groupByK](f: T => K)(implicit kt: ClassTagK]): RDD[(K, IterableT])]
特点:适用于需要根据某个规则将数据分组的场景,但需要注意shuffle操作带来的性能开销。
7. filter
功能:将数据根据指定的规则进行筛选过滤。
函数签名:def filter(f: T => Boolean): RDDT]
特点:适用于需要筛选数据的场景,筛选后分区不变,但分区内数据可能不均衡,需注意数据倾斜问题。
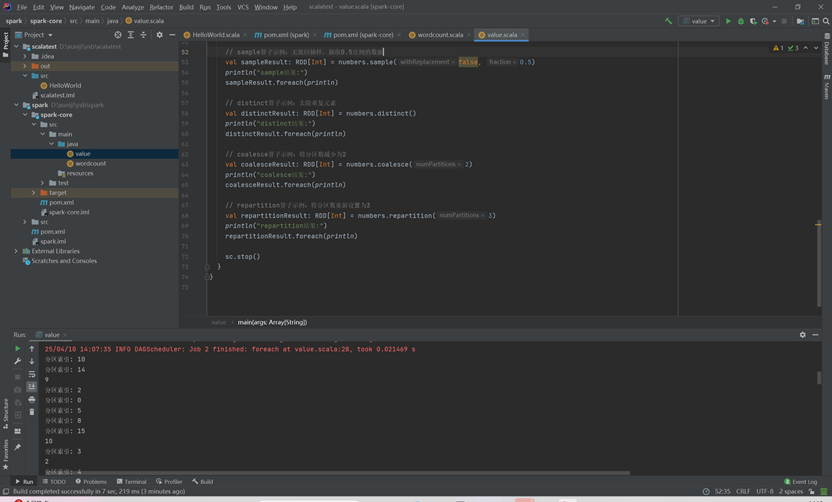
8. sample
功能:根据指定的规则从数据集中抽取数据,支持有放回和无放回抽样。
函数签名:def sample(withReplacement: Boolean, fraction: Double, seed: Long = Utils.random.nextLong): RDDT]
特点:适用于需要从大数据集中抽取样本数据的场景,支持伯努利抽样和泊松抽样。
9、Value类型算子补充
1、distinct
功能:去除数据集中的重复元素。
函数签名:def distinct()(implicit ord: OrderingT] = null): RDD[T] 或 def distinct(numPartitions: Int)(implicit ord: OrderingT] = null): RDD[T]
特点:可以用于去除RDD中的重复数据,可选地指定分区数以提高性能。
2、coalesce
功能:减少RDD的分区数,用于优化小数据集的执行效率。
函数签名:def coalesce(numPartitions: Int, shuffle: Boolean = false, partitionCoalescer: Option[PartitionCoalescer] = Option.empty)(implicit ord: OrderingT] = null): RDD[T]
特点:在不进行shuffle操作的情况下减少分区数,有助于减少小任务的数量,降低任务调度成本。
3、repartition
功能:重新分区RDD,无论增加还是减少分区数都会进行shuffle操作。
函数签名:def repartition(numPartitions: Int)(implicit ord: OrderingT] = null): RDD[T]
特点:通过shuffle过程重新分配数据到指定的分区数,适用于需要调整RDD分区数的场景。
4、sortBy
功能:对RDD中的元素进行排序。
函数签名:def sortByK](f: (T) => K, ascending: Boolean = true, numPartitions: Int = this.partitions.length)(implicit ord: OrderingK], ctag: ClassTagK]): RDDT]
特点:可以按照指定的函数处理结果进行排序,支持升序和降序,排序后RDD的分区数与原RDD的分区数一致(除非指定)。
- 双Value类型算子
1、intersection
功能:返回两个RDD的交集。
函数签名:def intersection(other: RDD[T]): RDD[T]
特点:适用于需要找出两个RDD中共有元素的场景。
2、union
功能:返回两个RDD的并集(不去重)。
函数签名:def union(other: RDD[T]): RDD[T]
特点:适用于需要合并两个RDD中所有元素的场景,但需要注意重复数据的问题。
4、subtract
功能:返回在第一个RDD中但不在第二个RDD中的元素(差集)。
函数签名:def subtract(other: RDD[T]): RDD[T]
特点:适用于需要从第一个RDD中去除与第二个RDD中相同元素的场景。
5、zip
功能:将两个RDD中的元素以键值对的形式合并,其中键为第一个RDD中的元素,值为第二个RDD中相同位置的元素。
函数签名:def zip[U: ClassTag](other: RDDU]): RDD[(T, U)]
特点:适用于需要将两个RDD中对应位置的元素进行合并的场景。
6、 partitionBy
功能:根据指定的Partitioner对数据重新进行分区。
函数签名:def partitionBy(partitioner: Partitioner): RDD[(K, V)]
特点:常用于自定义分区逻辑,以优化数据分布和后续处理性能。
示例:使用HashPartitioner对数据进行重新分区。
7、 groupByKey
功能:根据key对value进行分组。
特点:涉及shuffle操作,适用于需要对相同key的数据进行聚合的场景。但需要注意shuffle带来的性能开销。
8、reduceByKey
功能:对相同key的value进行聚合操作。
特点:在shuffle前可以对分区内相同key的数据进行预聚合,减少落盘数据量,提高性能。
与groupByKey的区别:reduceByKey包含分组和聚合功能,而groupByKey只能分组。
8、aggregateByKey
功能:对数据进行分区内和分区间聚合操作,允许不同的聚合规则。
特点:提供了更灵活的聚合方式,可以在分区内和分区间应用不同的聚合函数。
9、foldByKey
功能:当分区内和分区间聚合规则相同时,aggregateByKey的简化版。
函数签名:def foldByKey(zeroValue: V)(func: (V, V) => V): RDD[(K, V)]
特点:简化了aggregateByKey的使用,适用于聚合规则一致的场景。
10、 combineByKey
功能:最通用的对key-value型RDD进行聚集操作的函数。
函数签名:
scalaCopy Code
def combineByKey[C]( createCombiner: V => C, mergeValue: (C, V) => C, mergeCombiners: (C, C) => C): RDD[(K, C)]特点:允许用户定义如何组合单个值、如何在分区内合并值以及如何在分区间合并结果,提供了极大的灵活性。
11、 sortByKey
功能:根据key对数据进行排序。
函数签名:def sortByKey(ascending: Boolean = true, numPartitions: Int = self.partitions.length): RDD[(K, V)]
特点:要求K必须实现Ordered接口,适用于需要对key进行排序的场景。
12、join
功能:对两个具有相同key的RDD进行内连接操作。
函数签名:def joinW](other: RDD[(K, W)]): RDD[(K, (V, W))]
特点:返回一个包含相同key的所有元素连接在一起的RDD,适用于需要从多个数据源合并信息的场景。
13、 leftOuterJoin
功能:对两个RDD进行左外连接操作。
函数签名:def leftOuterJoinW](other: RDD[(K, W)]): RDD[(K, (V, OptionW]))]
特点:即使右RDD中不存在匹配的key,也会保留左RDD中的元素,并用Option.empty填充缺失的value,适用于需要保留左RDD所有元素的场景。
14、cogroup
功能:对两个RDD进行共组操作,即按key将两个RDD中的数据分组到一起。
函数签名:def cogroup[W](other: RDD[(K, W)]): RDD[(K, (Iterable[V], Iterable[W]))]
特点:返回一个包含两个RDD中相同key的所有元素分组在一起的RDD,但不对value进行合并,适用于需要对两个RDD中的数据进行细粒度控制的场景。