PyramidBox阅读笔记
PyramidBox: A Context-assisted Single Shot Face Detector(ECCV 2018)
论文链接:论文链接
代码链接:代码链接,原版代码在paddle,但是现在不知道为什么找不到了,这里提供的是其他版本
- 我是专门来看这篇文章中的context的做法的
- context能不能用于进行坐标回归里面,而不仅仅用在分类当中
- context相关论文:CMS-RCNN、SSH、FAN
动机
- 使用context解决小目标,模糊目标,部分遮挡的目标检测
解决方案
- 整体方案(基于context)
- Low-level Feature Pyramid Network(LFPN):将足够的high level特征和 low level 的特征结合在一起
- Context-sensitive prediction module (CPM):引入context信息
- PyramidAnchors:设计一种“context anchor”,通过半监督方法监督high level上下文特征学习
- Data-anchor-sampling:增加不同尺度的训练样本数量
网络结构
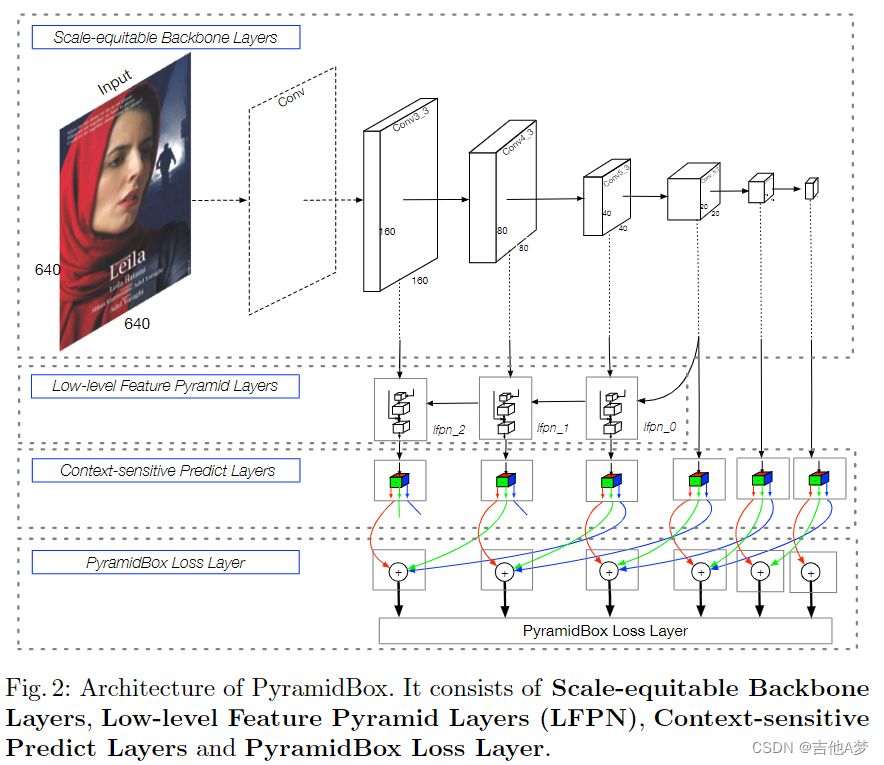
(能不能不要下采样,因为下采样之后,high-level的特征对应原图感受野太大了,特征融合之后的效果感觉更多的是一个整体的特征,并不能精细化)
Low-level Feature Pyramid Network(LFPN)

- 和FPN不一样的地方在于,LFPN将低层的一些特征进行了融合,而高层特征因为感受野太大了,不适合用于人脸检测
Context-sensitive Predict Module(CPM)
- CPM借鉴了SSH和DSSD。SSH通过在不同分支上不同的stride+conv堆叠来扩展感受野大小,学习更多的contextual information;DSSD使用residual block,得到deeper的预测分支。将SSH中的context module中的conv层换成DSSD的残差预测模块,这样CPM同时包含了DSSD+SSH的上下文信息的优势
- CPM的输出。 w l × h l × c l w_l×h_l×c_l wl×hl×cl,其中 w l = h l = 640 2 2 + l w_l=h_l=\frac{640}{2^{2+l}} wl=hl=22+l640(和LFPN每个输出特征图的大小一致),通道 c l = 20 c_l=20 cl=20,每个通道的特征分别用来进行分类和回归 面部、头部、身体。人脸分类需要4( = c p l + c n l =cp_l+cn_l =cpl+cnl)个通道(其中 c p l 、 c n l cp_l、cn_l cpl、cnl分别是前景和背景的max-in-out标签。若 l = 0 l=0 l=0那么 c p l = 1 cp_l=1 cpl=1,否则 c p l = 3 cp_l=3 cpl=3,这样设计是因为 l = 0 l=0 l=0时的特征图的感受野很小,其中的产生的小anchor很多,容易产生false positive,正负样本比例不平衡;而在其他层使用 c p l = 3 , c n l = 1 cp_l=3,cn_l=1 cpl=3,cnl=1可以提高召回率)。此外,头部和身体的分类各需要两个通道(分别对应前景和背景的scores),面部、头部和身体的定位各需要4个通道。
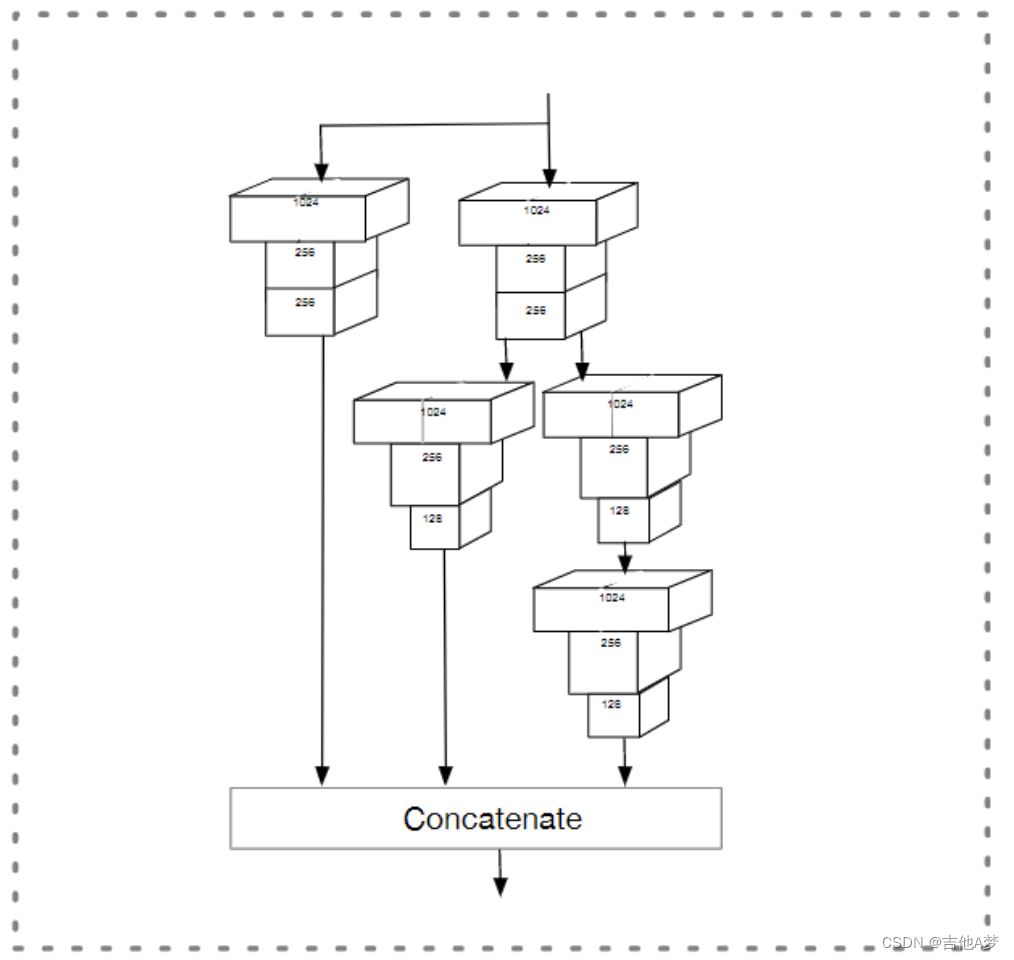
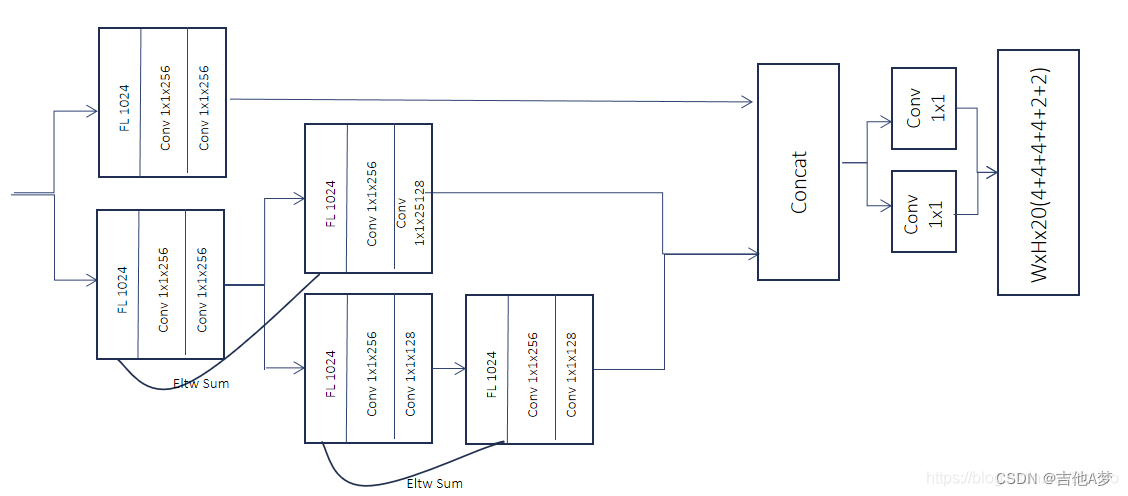
- Inception:SSH的思想来自于Inception。不同类型的卷积kernel会提取不同种类的信息。为了确定哪一个kernel的效果比较好,Inception 就将这些kernel全部试一下融合起来
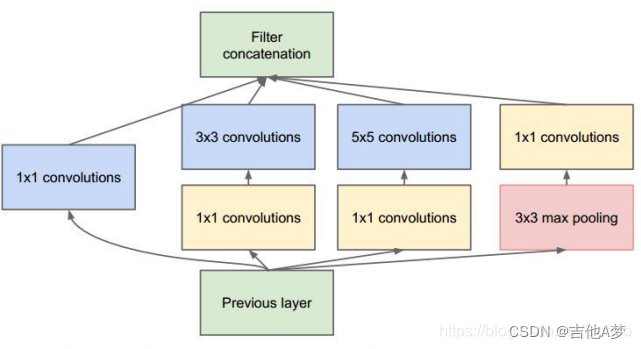
- SSH中的context模块:这个模块其实就是利用了Inception的原理。最后CPM应用的时候将其中的Conv变换成了ResNet中的卷积块(为什么SSH中的context模块可以提取context信息,这和FPN中的特征融合不是一样的吗?我可能需要去看一下SSH的论文)
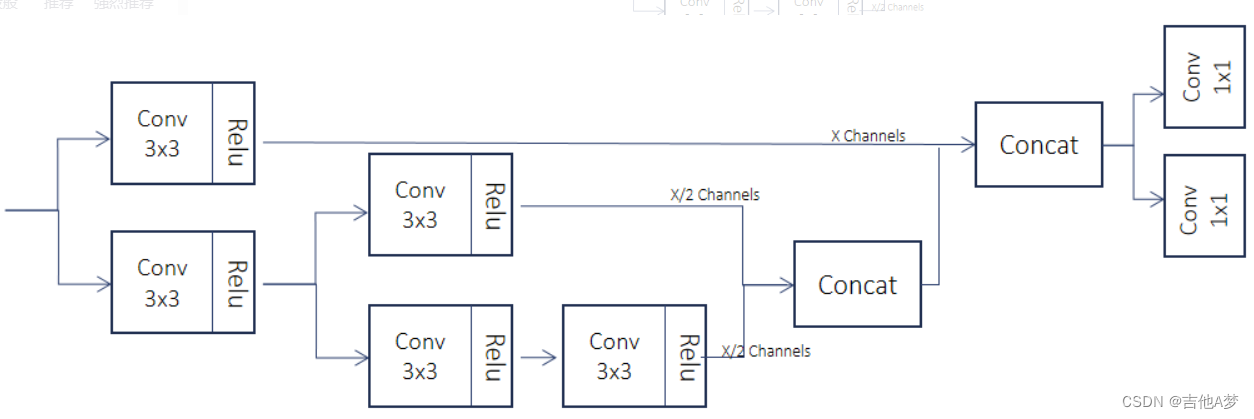
- Inception:SSH的思想来自于Inception。不同类型的卷积kernel会提取不同种类的信息。为了确定哪一个kernel的效果比较好,Inception 就将这些kernel全部试一下融合起来
Max-in-out
Max-out:Max-out是S3FD中提出的。在low-level的特征图中,anchor设置的比较小,这导致负样本数量急剧增加,容易发生false positive。为了解决这个问题,作者对于每一个小尺寸的anchor,进行N次二分类(区分前景和背景),选择这N次中背景score最大的作为这个anchor的背景score。
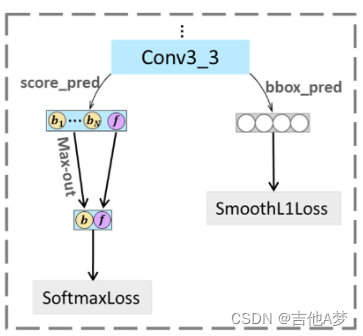
Max-in-out:Max-in-out就是把positive和negative anchor都做此处理,在正负样本上都使用这个策略。比如在low-level特征图上,对negative使用max-in-out以降低false positive;在其他特征图上,则对positive使用以提升召回率。
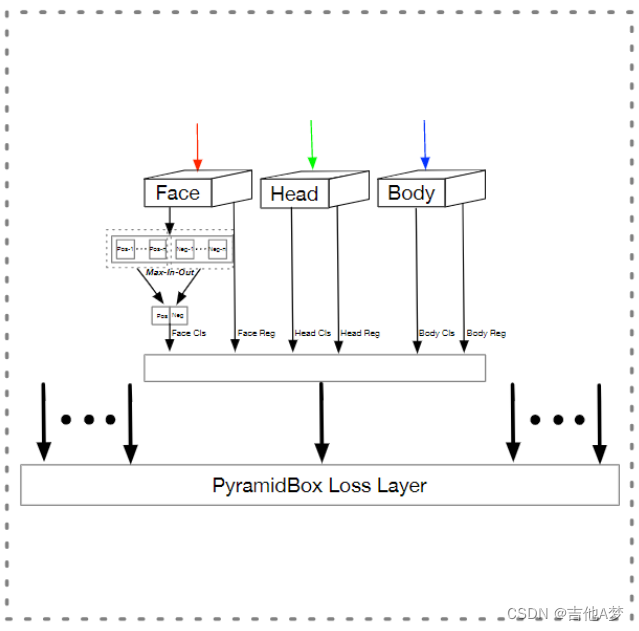
PyramidAnchors
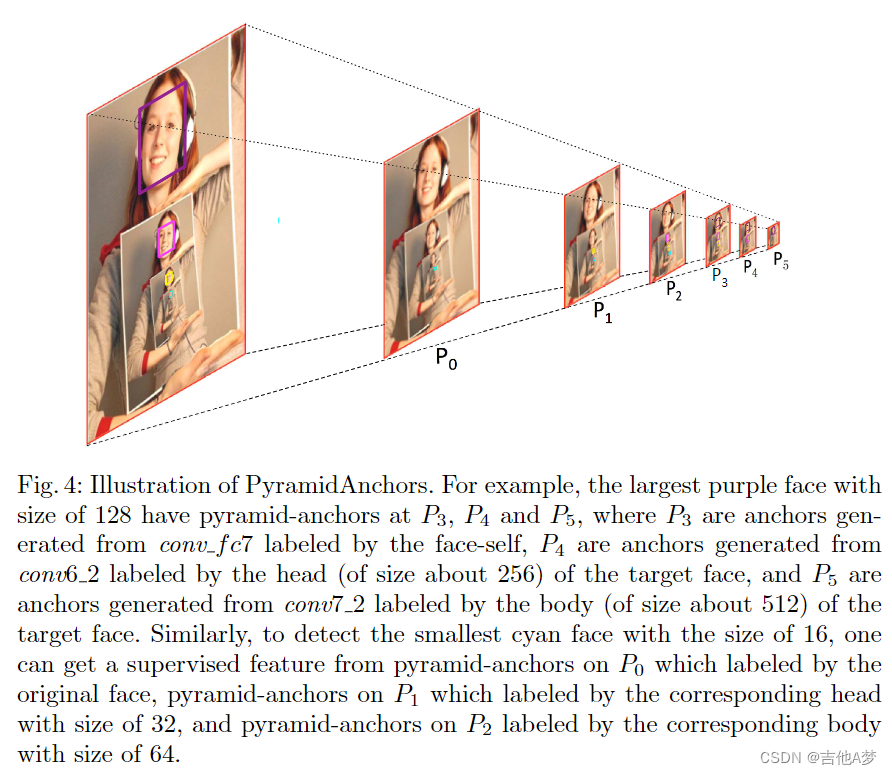
- PyramidAnchors生成的算法如下:
- 目标:确定 stride 为 s p a k s_{pa}^k spak ( k = 0 , 1 , … … , K k=0,1,……,K k=0,1,……,K,这里的k是一个指数操作,不是上标) 的特征图中对应 anchor 的标签
- 假设 r e g i o n t a r g e t region_{target} regiontarget 是原图上的gt区域, a n c h o r i , j anchor_{i,j} anchori,j 是第 i i i 个特征图上的第 j j j 个anchor,stride 为 s i s_i si, s p a k s_{pa}^k spak 是第 k k k 个特征图的 stride
- 使用下面这个公式来找到 stride 为 s p a k s_{pa}^k spak 的特征图中对应 anchor 的标签
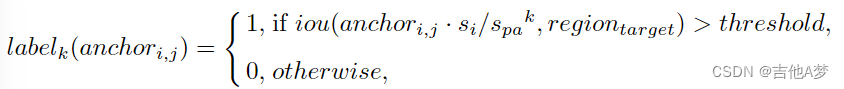
- “对应” 的含义:第 k k k 个特征图中的 anchor 来自 a n c h o r i , j anchor_{i,j} anchori,j ,先把 a n c h o r i , j anchor_{i,j} anchori,j 使用 stride s i s_i si 映射回原图,再从原图使用 s p a k s_{pa}^k spak 找到 a n c h o r i , j anchor_{i,j} anchori,j 对应在 stride 为 s p a k s_{pa}^k spak 的特征图中的 anchor
- 在作者的实验中, s p a = 2 s_{pa}=2 spa=2,因为相邻模块 stride 的差别就是 2。 t h r e s h h o l d = 0.35 , K = 2 threshhold=0.35,K=2 threshhold=0.35,K=2, l a b e l 0 , l a b e l 1 , l a b e l 2 label_0,label_1,label_2 label0,label1,label2 分别是脸、头、身子的标签。
- 简而言之,某一层的一个anchor与分配给了原图的某个gt,那么这个anchor的下一层对应位置的anchor的标签就是头,再下一层对应的anchor的标签就是身子,然后用这种方式的标签去进行训练,最后检测器的输出类别就是3类。
Data anchor sampling
引用
这篇文章讲得很细致:文章