Atomic原子类体系及CAS原理详解
文章目录
1. 什么是原子类
java 1.5引进原子类,具体在java.util.concurrent.atomic包下,atomic包里面一共提供了13个类,分为4种类型,分别是:原子更新基本类型,原子更新数组,原子更新引用,原子更新属性。原子类也是java实现同步的一套解决方案。
2. 什么情况下使用原子类
在很多时候,我们需要的仅仅是一个简单的、高效的、线程安全的递增或者递减方案,这个方案一般需要满足以下要求:
1、 简单:操作简单,底层实现简单
2、 高效:占用资源少,操作速度快
3、 安全:在高并发和多线程环境下要保证数据的正确性
对于是需要简单的递增或者递减的需求场景,使用synchronized关键字和lock固然可以实现,但代码写的会略显冗余,且性能会有影响,此时用原子类更加方便。
public class AtomicMain {

    public static void main(String[] args) throws InterruptedException {

        ExecutorService service = Executors.newCachedThreadPool();

        Count count = new Count();
        // 100个线程对共享变量进行加1
        for (int i = 0; i < 100; i++) {
            service.execute(() -> count.increase());
        }

        // 等待上述的线程执行完
        service.shutdown();
        service.awaitTermination(1, TimeUnit.DAYS);


        System.out.println("公众号:Java3y---------");
        System.out.println(count.getCount());
    }

}

class Count{

    // 共享变量
    private Integer count = 0;
    public Integer getCount() {
        return count;
    }
    public  void increase() {
        count++;
    }
}
多运行几次可以发现:结果是不确定的,可能是95,也可能是98,也可能是100
根据结果我们得知:上面的代码是线程不安全的!如果线程安全的代码,多次执行的结果是一致的!
我们可以发现问题所在:count++并不是原子操作。因为count++需要经过读取-修改-写入三个步骤。举个例子:
- 如果某一个时刻:线程A读到count的值是10,线程B读到count的值也是10
- 线程A对count++,此时count的值为11
- 线程B对count++,此时count的值也是11(因为线程B读到的count是10)
所以到这里应该知道为啥我们的结果是不确定了吧。
要将上面的代码变成线程安全的(每次得出的结果是100),那也很简单,毕竟我们是学过synchronized锁的人:在increase()加synchronized锁就好了
public synchronized void increase() {
    count++;
}
无论执行多少次,得出的都是100:
从上面的代码我们也可以发现,只做一个++这么简单的操作,都用到了synchronized锁,未免有点小题大做了。
Synchronized锁是独占的,意味着如果有别的线程在执行,当前线程只能是等待!
于是我们原子变量的类就登场了!
3. CAS是什么
来源维基百科:
比较并交换(compare and swap,CAS),是原子操作的一种,可用于在多线程编程中实现不被打断的数据交换操作,从而避免多线程同时改写某一数据时由于执行顺序不确定性以及中断的不可预知性产生的数据不一致问题。该操作通过将内存中的值与指定数据进行比较,当数值一样时将内存中的数据替换为新的值。
Java中CAS是基于unsafe类实现的,所有的unsafe类中的方法都是native类修饰的,直接调用操作系统底层资源执行响应的任务。
unsafe.compareAndSwapInt(this, valueOffset, expect, update);
这是一条调用unsafe类中的compareAndSwapInt的方法,this表示当前对象,valueoffset表示当前对象的偏移地址,expect表示预期值
update表示更新值。作用是如果预期值和该对象偏移地址中的值一样,就用更新值更新偏移地址中的值。
CAS有3个操作数:
- 内存值V
- 旧的预期值A
- 要修改的新值B
当多个线程尝试使用CAS同时更新同一个变量时,只有其中一个线程能更新变量的值(A和内存值V相同时,将内存值V修改为B),而其它线程都失败,失败的线程并不会被挂起,而是被告知这次竞争中失败,并可以再次尝试(或者什么都不做)。
我们可以发现CAS有两种情况:
- 如果内存值V和我们的预期值A相等,则将内存值修改为B,操作成功!
- 如果内存值V和我们的预期值A不相等,一般也有两种情况:
- 重试(自旋)
- 什么都不做
3.1 CAS失败重试(自旋)
比如说,我上面用了100个线程,对count值进行加1。我们都知道:如果在线程安全的情况下,这个count值最终的结果一定是为100的。那就意味着:每个线程都会对这个count值实质地进行加1。

上面图只模拟出两个线程的情况,但足够说明问题了。
3.2 CAS失败什么都不做
上面是每个线程都要为count值加1,但我们也可以有这种情况:将count值设置为5

理解CAS的核心就是:CAS是原子性的,虽然你可能看到比较后再修改(compare and swap)觉得会有两个操作,但终究是原子性的!
4. 原子变量类简单介绍
原子变量类在java.util.concurrent.atomic包下,总体来看有这么多个:
- 基本类型:
- AtomicBoolean:布尔型
- AtomicInteger:整型
- AtomicLong:长整型
- 数组:
- AtomicIntegerArray:数组里的整型
- AtomicLongArray:数组里的长整型
- AtomicReferenceArray:数组里的引用类型
- 引用类型:
- AtomicReference:引用类型
- AtomicStampedReference:带有版本号的引用类型
- AtomicMarkableReference:带有标记位的引用类型
- 对象的属性:
- AtomicIntegerFieldUpdater:对象的属性是整型
- AtomicLongFieldUpdater:对象的属性是长整型
- AtomicReferenceFieldUpdater:对象的属性是引用类型
JDK8新增DoubleAccumulator、LongAccumulator、DoubleAdder、LongAdder是对AtomicLong等类的改进。比如LongAccumulator与LongAdder在高并发环境下比AtomicLong更高效。
Atomic包里的类基本都是使用Unsafe实现的包装类。
Unsafe里边有几个我们喜欢的方法(CAS):
// 第一和第二个参数代表对象的实例以及地址,第三个参数代表期望值,第四个参数代表更新值
public final native boolean compareAndSwapObject(Object var1, long var2, Object var4, Object var5);

public final native boolean compareAndSwapInt(Object var1, long var2, int var4, int var5);

public final native boolean compareAndSwapLong(Object var1, long var2, long var4, long var6);
从原理上概述就是:Atomic包的类的实现绝大调用Unsafe的方法,而Unsafe底层实际上是调用C代码,C代码调用汇编,最后生成出一条CPU指令cmpxchg,完成操作。这也就为啥CAS是原子性的,因为它是一条CPU指令,不会被打断。
5. 原子变量类使用
5.1 基本类型原子类
这里以原子更新基本类型中的AtomicInteger类为例,介绍通用的API接口和使用方法。
首先是几个常用的API:
public final int set() //设一个值
public final int get() //获取当前的值
public final int getAndSet(int newValue)//获取当前的值,并设置新的值
public final int getAndIncrement()//获取当前的值,并自增
public final int getAndDecrement() //获取当前的值,并自减
public final int getAndAdd(int delta) //获取当前的值,并加上预期的值
boolean compareAndSet(int expect, int update) //如果当前值等于预期值,则以原子方式将该值设置为输入值(update)
public final void lazySet(int newValue) //最终设置为newValue,使用 lazySet 设置之后可能导致其他线程在之后的一小段时间内还是可以读到旧的值。
使用示例:
public class AtomicIntegerTest {

    public static void main(String[] args) {

        AtomicInteger a = new AtomicInteger(0);
        for (int i = 1; i < 5; i++) {
            a.getAndIncrement(); // a 自增,相当于 a ++
        }
        //获取当前a的值
        System.out.println("AtomicInteger a从0自增4次结果为:"+ a.get());

        System.out.println("AtomicInteger 当前a为:"+ a.getAndDecrement() + ",并自减一次"); //a --

        //获取当前a的值,并更新a为8
        System.out.println("AtomicInteger a当前值为:"+a.getAndSet(8)+",并更新a为8");

        //获取当前a的值,并将a加6
        System.out.println("AtomicInteger a当前值为:"+a.getAndAdd(6)+",并将a加6");

        a.compareAndSet(12,9); //如果a=12,就把a更新为9,否则不进行操作
        System.out.println("AtomicInteger a当前值为:"+a.get());

        a.compareAndSet(14,9); //如果a=14,就把a更新为9,否则不进行操作
        System.out.println("AtomicInteger a当前值为:"+a.get());

    }
}
结果:

5.2 数组类型原子类
这里以AtomicIntegerArray 为例,介绍通用的API接口和使用方法。
首先是几个常用的API:
public final int get(int i) //获取 index=i 位置元素的值
public final int set(int i, int newValue) //为 index=i 位置元素设新值
public final int getAndSet(int i, int newValue) //返回 index=i 位置的当前的值,并将其设置为新值:newValue
public final int getAndIncrement(int i) //获取 index=i 位置元素的值,并让该位置的元素自增
public final int getAndDecrement(int i) //获取 index=i 位置元素的值,并让该位置的元素自减
public final int getAndAdd(int i, int delta) //获取 index=i 位置元素的值,并加上预期的值
boolean compareAndSet(int i, int expect, int update) //如果index=i 位置的值等于预期值,则以原子方式将 index=i 位置的元素值设置为输入值(update)
public final void lazySet(int i, int newValue) //最终 将index=i 位置的元素设置为newValue,使用 lazySet 设置之后可能导致其他线程在之后的一小段时间内还是可以读到旧的值。
代码示例:
public class AtomicIntegerArrayTest {

    public static void main(String[] args) {

        int[] a = {1,1,1,1};
        AtomicIntegerArray arr = new AtomicIntegerArray(a);
        System.out.println("arr数组初始值为:" +arr.toString());

        for (int i = 0; i < 4; i++) {
            arr.getAndIncrement(i); //index = i位置上的值arr[i]自增,相当于 a[i] ++
        }
        System.out.println("arr数组每个元素都自增1后为:" +arr.toString());
        //获取当前arr[1]的值
        System.out.println("arr[1]的值为:"+ arr.get(1));

        System.out.println("arr[2]当前值为:"+ arr.getAndDecrement(2) + ",并让arr[2]自减一次"); //a[2]--

        //获取当前a[2]的值,并更新a为8
        System.out.println("arr[2]当前值为:"+arr.getAndSet(2,8)+",并更新a[2]为8");

        //获取当前a的值,并将a加6
        System.out.println("arr[2]当前值为:"+arr.getAndAdd(2,6)+",并将a[2]加6");

        arr.compareAndSet(2,12,9); //如果a[2]=12,就把a[2]更新为9,否则不进行操作
        System.out.println("arr[2]当前值为:"+arr.get(2));

        arr.compareAndSet(2,14,9); //如果a[2]=14,就把a[2]更新为9,否则不进行操作
        System.out.println("arr[2]当前值为:"+arr.get(2));
    }
}
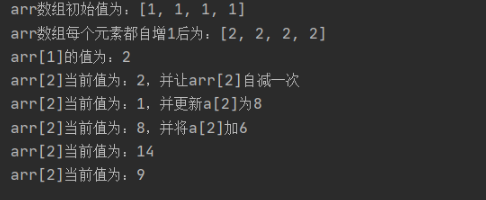
结果:
5.3 引用类型原子类
public class User {
    private String name;
    private int age;

    public User(String name, int age) {
        this.name = name;
        this.age = age;
    }

    public String getName() {
        return this.name;
    }

    public void setName(final String name) {
        this.name = name;
    }

    public int getAge() {
        return this.age;
    }

    public void setAge(final int age) {
        this.age = age;
    }

    @Override
    public String toString() {
        return "User{" +
                "name='" + name + '\'' +
                ", age=" + age +
                '}';
    }
}
public class AtomicReferenceTest {

    public static void main(String[] args) {
        AtomicReference<User> u = new AtomicReference<>();

        User user1 = new User("金厂长",35);
        User user2 = new User("木易阿婆",26);
        User user3 = new User("快乐的小lau",22);

        u.set(user1);

        // 查看当前对象并设为新对象user2
        System.out.println("当前对象为:"+u.getAndSet(user2)+",并设置新对象为user2");
        System.out.println("当前对象为:"+u.get());

        System.out.println("如果当前对象为user2,就把当前对象设为user3,否则不操作");
        u.compareAndSet(user2,user3); //如果当前对象为user2则把当前对象设为user3
        System.out.println("当前对象为:"+u.get());
    }
}
5.4 ABA问题
使用CAS有个缺点就是ABA的问题,什么是ABA问题呢?首先我用文字描述一下:
- 现在我有一个变量count=10,现在有三个线程,分别为A、B、C
- 线程A和线程C同时读到count变量,所以线程A和线程C的内存值和预期值都为10
- 此时线程A使用CAS将count值修改成100
- 修改完后,就在这时,线程B进来了,读取得到count的值为100(内存值和预期值都是100),将count值修改成10
- 线程C拿到执行权,发现内存值是10,预期值也是10,将count值修改成11
上面的操作都可以正常执行完的,这样会发生什么问题呢??线程C无法得知线程A和线程B修改过的count值,这样是有风险的。

5.5 解决ABA问题
ABA问题:简单讲就是多线程环境,2次读写中一个线程修改A->B,然后又B->A,另一个线程看到的值未改变,又继续修改成自己的期望值。当然我们如果不关心过程,只关心结果,那么这个就是无所谓的ABA问题。
为了解决ABA问题,java为我们提供了AtomicMarkableReference和AtomicStampedReference类,为我们解决了问题
AtomicStampedReference是利用版本戳的形式记录了每次改变以后的版本号,这样的话就不会存在ABA问题了
举个通俗点的例子,你倒了一杯水放桌子上,干了点别的事,然后同事把你水喝了又给你重新倒了一杯水,你回来看水还在,拿起来就喝,如果你不管水中间被人喝过,只关心水还在,这就是ABA问题。如果你是一个讲卫生讲文明的小伙子,不但关心水在不在,还要在你离开的时候水被人动过没有,因为你是程序员,所以就想起了放了张纸在旁边,写上初始值0,别人喝水前麻烦先做个累加才能喝水。这就是AtomicStampedReference的解决方案。
5.6 AtomicStampedReference
AtomicStampedReference在构建的时候需要一个类似于版本号的int类型变量stamped,每一次针对共享数据的变化都会导致该 stamped 的变化(stamped 需要应用程序自身去负责,AtomicStampedReference并不提供,一般使用时间戳作为版本号),因此就可以避免ABA问题的出现,AtomicStampedReference的使用也是极其简单的,创建时我们不仅需要指定初始值,还需要设定stamped的初始值,在AtomicStampedReference的内部会将这两个变量封装成Pair对象,代码如下所示。
	//静态内部类,封装了 变量引用 和 版本号
	private static class Pair<T> {
        final T reference;  // 变量引用
        final int stamp;    // 版本号
        private Pair(T reference, int stamp) {
            this.reference = reference;
            this.stamp = stamp;
        }
        static <T> Pair<T> of(T reference, int stamp) {
            return new Pair<T>(reference, stamp);
        }
    }

    private volatile Pair<V> pair;

    /**
     *
     * @param initialRef  初始变量引用
     * @param initialStamp  版本号
     */
    public AtomicStampedReference(V initialRef, int initialStamp) {
        pair = Pair.of(initialRef, initialStamp);
    }
常用方法:
// 构造函数,初始化引用和版本号
public AtomicStampedReference(V initialRef, int initialStamp)

// 以原子方式获取当前引用值
public V getReference()

// 以原子方式获取当前版本号
public int getStamp()

// 以原子方式获取当前引用值和版本号
public V get(int[] stampHolder)

// 以原子的方式同时更新引用值和版本号
// 当期望引用值不等于当前引用值时,操作失败,返回false
// 当期望版本号不等于当前版本号时,操作失败,返回false
// 在期望引用值和期望版本号同时等于当前值的前提下
// 当新的引用值和新的版本号同时等于当前值时,不更新,直接返回true
// 当新的引用值和新的版本号不同时等于当前值时,同时设置新的引用值和新的版本号,返回true
public boolean weakCompareAndSet(V  expectedReference,
                                 V  newReference,
                                 int expectedStamp,
                                 int newStamp)

// 以原子的方式同时更新引用值和版本号
// 当期望引用值不等于当前引用值时,操作失败,返回false
// 当期望版本号不等于当前版本号时,操作失败,返回false
// 在期望引用值和期望版本号同时等于当前值的前提下
// 当新的引用值和新的版本号同时等于当前值时,不更新,直接返回true
// 当新的引用值和新的版本号不同时等于当前值时,同时设置新的引用值和新的版本号,返回true
public boolean compareAndSet(V   expectedReference,
                             V   newReference,
                             int expectedStamp,
                             int newStamp)

// 以原子方式设置引用的当前值为新值newReference
// 同时,以原子方式设置版本号的当前值为新值newStamp
// 新引用值和新版本号只要有一个跟当前值不一样,就进行更新
public void set(V newReference, int newStamp)

// 以原子方式设置版本号为新的值
// 前提:引用值保持不变
// 当期望的引用值与当前引用值不相同时,操作失败,返回fasle
// 当期望的引用值与当前引用值相同时,操作成功,返回true
public boolean attemptStamp(V expectedReference, int newStamp)

// 使用`sun.misc.Unsafe`类原子地交换两个对象
private boolean casPair(Pair<V> cmp, Pair<V> val)
代码示例:
	public static void main(String[] args) {

        String str1 = "aaa";
        String str2 = "bbb";
        AtomicStampedReference<String> reference = new AtomicStampedReference<String>(str1,1);
        reference.compareAndSet(str1,str2,reference.getStamp(),reference.getStamp()+1);
        System.out.println("reference.getReference() = " + reference.getReference());

        boolean b = reference.attemptStamp(str2, reference.getStamp() + 1);
        System.out.println("b: "+b);
        System.out.println("reference.getStamp() = "+reference.getStamp());

        boolean c = reference.weakCompareAndSet(str2,"ccc",4, reference.getStamp()+1);
        System.out.println("reference.getReference() = "+reference.getReference());
        System.out.println("c = " + c);
    }

输出:
reference.getReference() = bbb
b: true
reference.getStamp() = 3
reference.getReference() = bbb
c = false
c为什么输出false呢, 因为版本戳不一致啦
5.7 对象属性修改类型原子类
以AtomicIntegerFieldUpdater 为例介绍一下简单使用方法:
public class User {
    private String name;
    volatile int age;

    public User(String name, int age) {
        this.name = name;
        this.age = age;
    }

    public String getName() {
        return this.name;
    }

    public void setName(final String name) {
        this.name = name;
    }

    public int getAge() {
        return this.age;
    }

    public void setAge(final int age) {
        this.age = age;
    }

    @Override
    public String toString() {
        return "User{" +
                "name='" + name + '\'' +
                ", age=" + age +
                '}';
    }
}
public class AtomicIntegerFieldUpdaterTest {
    public static void main(String[] args) {
        User user = new User("菜鸡",28);
        AtomicIntegerFieldUpdater<User> u = AtomicIntegerFieldUpdater.newUpdater(User.class,"age");

        u.addAndGet(user,5);
        System.out.println(user.toString());

    }
}
结果:

这里值得注意的是:使用AtomicIntegerFieldUpdater.newUpdater修改属性时:
- 被修改的属性必须是volatile类型的,在线程之间共享变量时保证立即可见,
- 属性的修饰符(public/protected/default/private)要保证当前操作对该属性可以直接进行,比如当我们用private volatile int age 时就会报错,因为private修饰时,外部无法访问也无法修改。
- 只能是实例变量,不能是类变量,也就是说不能加static关键字。
- 只能是可修改变量,不能使final变量,因为final的语义就是不可修改。
- 对于AtomicIntegerFieldUpdater和AtomicLongFieldUpdater只能修改int/long类型的字段,不能修改其包装类型(Integer/Long)。如果要修改包装类型就需要使用AtomicReferenceFieldUpdater。
5.8 LongAdder
AtomicLong通过循环CAS实现原子操作,缺点是当高并发下竞争比较激烈的时候,会出现大量的CAS失败,导致循环CAS次数大大增加,这种自旋是要消耗时间cpu时间片的,会占用大量cpu的时间,降低效率。
那这个问题如何解决呢?
Java 8推出了一个新的类,LongAdder,他就是尝试使用分段CAS以及自动分段迁移的方式来大幅度提升多线程高并发执行CAS操作的性能!
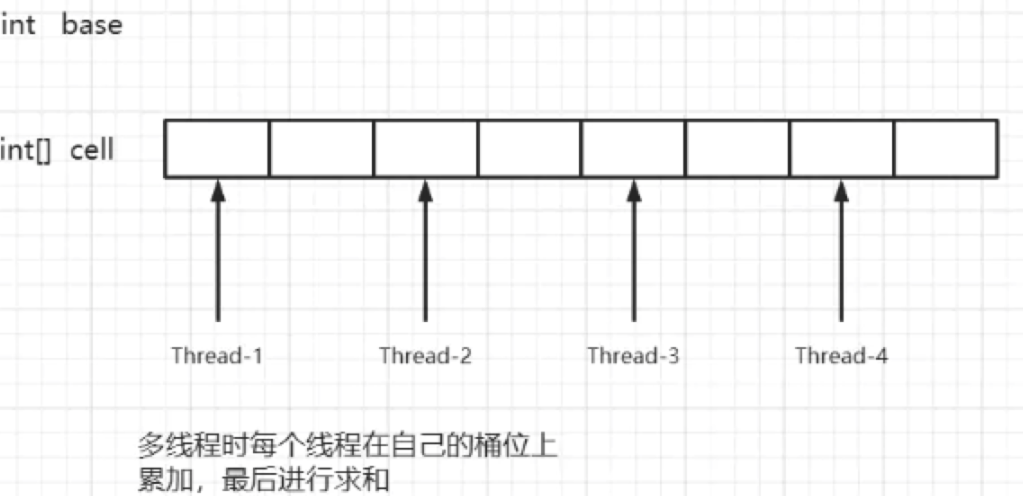
它的作用和AtomicLong是一样的,都是一个实现了原子操作的累加器,LongAdder通过维护一个基准值base和 Cell 数组,多线程的时候多个线程去竞争Cell数组的不同的元素,进行cas累加操作,并且每个线程竞争的Cell的下标不是固定的,如果CAS失败,会重新获取新的下标去更新,从而极大地减少了CAS失败的概率,最后在将base 和 Cell数组的元素累加,获取到我们需要的结果。
LongAdder的内部做了一个分段锁,类似于分段锁的概念。在它内部的时候,会把一个值放到一个数组里,比如说数组长度是4,最开始是0,1000个线程,250个线程锁在第一个数租元素里,以此类推,每一个都往上递增算出来结果在加到一起。
5.8.1 性能对比
示例代码:
题目:热点商品点赞计算器,点赞数加加统计,不要求实时精确。50个线程,每个线程100W次,统计总点赞数
比较synchronized、AtomicInteger、AtomicLong、LongAdder、LongAccumulator五种计数性能
class ClickNumber{
    int number = 0;
    public synchronized void add_synchronized(){
        number++;
    }

    AtomicInteger atomicInteger = new AtomicInteger();
    public void add_AtomicInteger(){
        atomicInteger.incrementAndGet();
    }

    AtomicLong atomicLong = new AtomicLong();
    public void add_AtomicLong(){
        atomicLong.incrementAndGet();
    }

    LongAdder longAdder = new LongAdder();
    public void add_LongAdder(){
        longAdder.increment();
    }

    LongAccumulator longAccumulator = new LongAccumulator((x,y)->x+y,0);
    public void add_longAccumulator(){
        longAccumulator.accumulate(1);
    }
}

public class LongAdderCalcDemo {
    public static final int SIZE_THREAD = 50;
    public static final int _1w = 10000;

    public static void main(String[] args) throws InterruptedException {
        ClickNumber clickNumber = new ClickNumber();
        long startTime = System.currentTimeMillis();
        long endTime = System.currentTimeMillis();
        CountDownLatch latch_synchronized = new CountDownLatch(SIZE_THREAD);
        CountDownLatch latch_AtomicInteger= new CountDownLatch(SIZE_THREAD);
        CountDownLatch latch_AtomicLong = new CountDownLatch(SIZE_THREAD);
        CountDownLatch latch_LongAdder = new CountDownLatch(SIZE_THREAD);
        CountDownLatch latch_LongAccumulator = new CountDownLatch(SIZE_THREAD);

        startTime = System.currentTimeMillis();
        for (int i = 1; i <= SIZE_THREAD; i++) {
            new Thread(()->{
                try {
                    for (int j = 1; j <= 100*_1w; j++) {
                        clickNumber.add_synchronized();
                    }
                } catch (Exception e) {
                    e.printStackTrace();
                } finally {
                    latch_synchronized.countDown();
                }
            },String.valueOf(i)).start();
        }
        latch_synchronized.await();
        endTime = System.currentTimeMillis();
        System.out.println("synchronized花费时间:"+ (endTime-startTime)+" 数值为:"+clickNumber.number);


        startTime = System.currentTimeMillis();
        for (int i = 1; i <= SIZE_THREAD; i++) {
            new Thread(()->{
                try {
                    for (int j = 1; j <= 100*_1w; j++) {
                        clickNumber.add_AtomicInteger();
                    }
                } catch (Exception e) {
                    e.printStackTrace();
                } finally {
                    latch_AtomicInteger.countDown();
                }
            },String.valueOf(i)).start();
        }
        latch_AtomicInteger.await();
        endTime = System.currentTimeMillis();
        System.out.println("AtomicInteger花费时间:"+ (endTime-startTime)+" 数值为:"+clickNumber.atomicInteger.get());

        startTime = System.currentTimeMillis();
        for (int i = 1; i <= SIZE_THREAD; i++) {
            new Thread(()->{
                try {
                    for (int j = 1; j <= 100*_1w; j++) {
                        clickNumber.add_AtomicLong();
                    }
                } catch (Exception e) {
                    e.printStackTrace();
                } finally {
                    latch_AtomicLong.countDown();
                }
            },String.valueOf(i)).start();
        }
        latch_AtomicLong.await();
        endTime = System.currentTimeMillis();
        System.out.println("AtomicLong花费时间:"+ (endTime-startTime)+" 数值为:"+clickNumber.atomicLong.get());

        startTime = System.currentTimeMillis();
        for (int i = 1; i <= SIZE_THREAD; i++) {
            new Thread(()->{
                try {
                    for (int j = 1; j <= 100*_1w; j++) {
                        clickNumber.add_LongAdder();
                    }
                } catch (Exception e) {
                    e.printStackTrace();
                } finally {
                    latch_LongAdder.countDown();
                }
            },String.valueOf(i)).start();
        }
        latch_LongAdder.await();
        endTime = System.currentTimeMillis();
        System.out.println("LongAdder花费时间:"+ (endTime-startTime)+" 数值为:"+clickNumber.longAdder.longValue());

        startTime = System.currentTimeMillis();
        for (int i = 1; i <= SIZE_THREAD; i++) {
            new Thread(()->{
                try {
                    for (int j = 1; j <= 100*_1w; j++) {
                        clickNumber.add_longAccumulator();
                    }
                } catch (Exception e) {
                    e.printStackTrace();
                } finally {
                    latch_LongAccumulator.countDown();
                }

            },String.valueOf(i)).start();
        }
        latch_LongAccumulator.await();
        endTime = System.currentTimeMillis();
        System.out.println("LongAccumulator花费时间:"+ (endTime-startTime)+" 数值为:"+clickNumber.longAccumulator.longValue());

    }
}
结果:

通过结果,可知LongAdder性能最优,花费时间最短,远优于AtomicLong
5.8.2 LongAdder为何那么快
1. LongAdder的基本思路
LongAdder的基本思路就是分散热点,将value值分散到一个Cell数组中,不同线程会命中到数组的不同槽中,各个线程只对自己槽中的那个值进行CAS操作,这样热点就被分散了,冲突的概率就小很多。如果要获取真正的long值,只要将各个槽中的变量值累加返回。sum()会将所有Cell数组中的value和base累加作为返回值,核心的思想就是将之前AtomicLong一个value的更新压力分散到多个value中去,从而降级更新热点。
2. LongAdder的原理
LongAdder在无竞争的情况,跟AtomicLong一样,对同一个base进行操作(无并发,单线程下直接CAS操作更新base值;非竞态条件下,直接累加到变量base上)
当出现竞争关系时则是采用化整为零的做法,从空间换时间,用一个数组cells,将一个value拆分进这个数组Cells.多个线程需要同时对value进行操作时,可以对线程id进行hash得到hash值,再根据hash值映射到这个数组cells的某个下标,再对该下标所对应的值进行自增操作。当所有线程操作完毕,将数组cells的所有值和无竞争值base都加起来作为最终结果。(有并发,多线程下分段CAS操作更新Cell数组值;竞态条件下,累加个各个线程自己的槽Cell[]中)

sum()公式
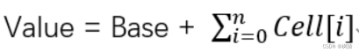
3. 源码解析
sum(); LongAdder的获取累加结果的方法,由于在sum中没有任何的加锁的操作,在遍历获取cells中的值的时候,可能有线程在拓容累加等操作,所以sum返回的值并不精确,不是一个原子快照
public long sum() {
    Cell[] as = cells; Cell a;
    long sum = base;
    if (as != null) {
        for (int i = 0; i < as.length; ++i) {
            if ((a = as[i]) != null)
                sum += a.value;
        }
    }
    return sum;
}
sum执行时,并没有限制对base和cells的更新。所以LongAdder不是强一致性的,它是最终一致性的(也就是说并发情况下,sum的值并不精确)
首先,最终返回的sum局部变量,初始被复制为base,而最终返回时,很可能base已经被更新了,而此时局部变量sum不会更新,造成不一致。其次,这里对cell的读取也无法保证是最后一次写入的值。所以,sum方法在没有并发的情况下,可以获得正确的结果
LongAdder.add()
public void add(long x) {
    Cell[] as; long b, v; int m; Cell a;
    if ((as = cells) != null || !casBase(b = base, b + x)) {  //(1)
        boolean uncontended = true;                           //(2)
        if (as == null || (m = as.length - 1) < 0 ||          //(3)
            (a = as[getProbe() & m]) == null ||               //(4)
            !(uncontended = a.cas(v = a.value, v + x)))       //(5)
            longAccumulate(x, null, uncontended);
    }
}
(1)逻辑为: cells 为null 并且cas更新base成功,则直接返回结果不进行后续判断,
(3)(4)(5) 逻辑为: cells !=null && as[getProbe() & m] != null && cas更新as[getProbe() & m] 成功,则直接结束,否则就会执行longAccumulate(x, null, uncontended)方法
(2)(5) uncontended 用来记录cas更新cell元素失败
小结
- 1.最初无竞争时只更新base;
- 2.如果更新base失败后,首次新建一个Cell[]数组
- 3.当多个线程竞争同一个CelI比较激烈时,可能就要对Cell[]扩容
LongAdder.longAccumulate()
//long X需要增加的值,一般默认都是1
//LongBinaryOperator fn默认传递的是null
//wasUncontended竞争标识,如果是false则代表有竞争。只有cells初始化之后, 并且当前失败,才会是false
final void longAccumulate(long x, LongBinaryOperator fn,
                              boolean wasUncontended) {
        // 用于通过 h & cells.length -1 计算线程操作的位置
        int h;
        // 判断线程的probe是否初始化
        if ((h = getProbe()) == 0) {
            // 初始化线程probe
            ThreadLocalRandom.current(); // force initialization
            h = getProbe();
            wasUncontended = true;
        }
        // 用于记录cell数组当前是否存在空的桶,false表示大概率存在空桶,及时满足拓容条件也暂时先不拓容
        boolean collide = false;                // True if last slot nonempty
        for (;;) {
            Cell[] as; Cell a; int n; long v;
            // cells 是否为空
            if ((as = cells) != null && (n = as.length) > 0) {
                if ((a = as[(n - 1) & h]) == null) {
                    // cells 不为空,并且线程操作桶为null,则new Cell(x)并更新
                    if (cellsBusy == 0) {       // Try to attach new Cell
                        Cell r = new Cell(x);   // Optimistically create
                        if (cellsBusy == 0 && casCellsBusy()) {
                            boolean created = false;
                            try {               // Recheck under lock
                                Cell[] rs; int m, j;
                                if ((rs = cells) != null &&
                                    (m = rs.length) > 0 &&
                                    rs[j = (m - 1) & h] == null) {
                                    rs[j] = r;
                                    created = true;
                                }
                            } finally {
                                cellsBusy = 0;
                            }
                            if (created)
                                break;
                            continue;           // Slot is now non-empty
                        }
                    }
                    collide = false;
                }
                // 在LongAdder.add()方法中已经cas过一次,如果probe没有更新,则直接进行a.cas操作大概率失败,则加了此次判断
                else if (!wasUncontended)       // CAS already known to fail
                    wasUncontended = true;      // Continue after rehash
                else if (a.cas(v = a.value, ((fn == null) ? v + x :
                                             fn.applyAsLong(v, x))))
                    break;
                // cell数组长度大于cpu数,则后续不再拓容
                // cells != as 正在拓容,则下次循环有空桶的概率较大 将collide = false,下次执行到此处则会advanceProbe(h) 一次而非直接拓容
                else if (n >= NCPU || cells != as)
                    collide = false;            // At max size or stale
                else if (!collide)
                    collide = true;
                // 拓容,每次为 数组长度 << 1
                else if (cellsBusy == 0 && casCellsBusy()) {
                    try {
                        if (cells == as) {      // Expand table unless stale
                            Cell[] rs = new Cell[n << 1];
                            for (int i = 0; i < n; ++i)
                                rs[i] = as[i];
                            cells = rs;
                        }
                    } finally {
                        cellsBusy = 0;
                    }
                    collide = false;
                    continue;                   // Retry with expanded table
                }
                // 每次失败后都会修改probe值,重新进入循环,而非probe不变
                h = advanceProbe(h);
            }
            // cells 为null,则初始化cells,初始size为2
            else if (cellsBusy == 0 && cells == as && casCellsBusy()) {
                boolean init = false;
                try {                           // Initialize table
                    if (cells == as) {
                        Cell[] rs = new Cell[2];
                        rs[h & 1] = new Cell(x);
                        cells = rs;
                        init = true;
                    }
                } finally {
                    cellsBusy = 0;
                }
                if (init)
                    break;
            }
            // cells 为null ,并且cellsBusy 锁竞争失败,则其他线程正在初始化,尝试casBase
            else if (casBase(v = base, ((fn == null) ? v + x :
                                        fn.applyAsLong(v, x))))
                break;                          // Fall back on using base
        }
    }
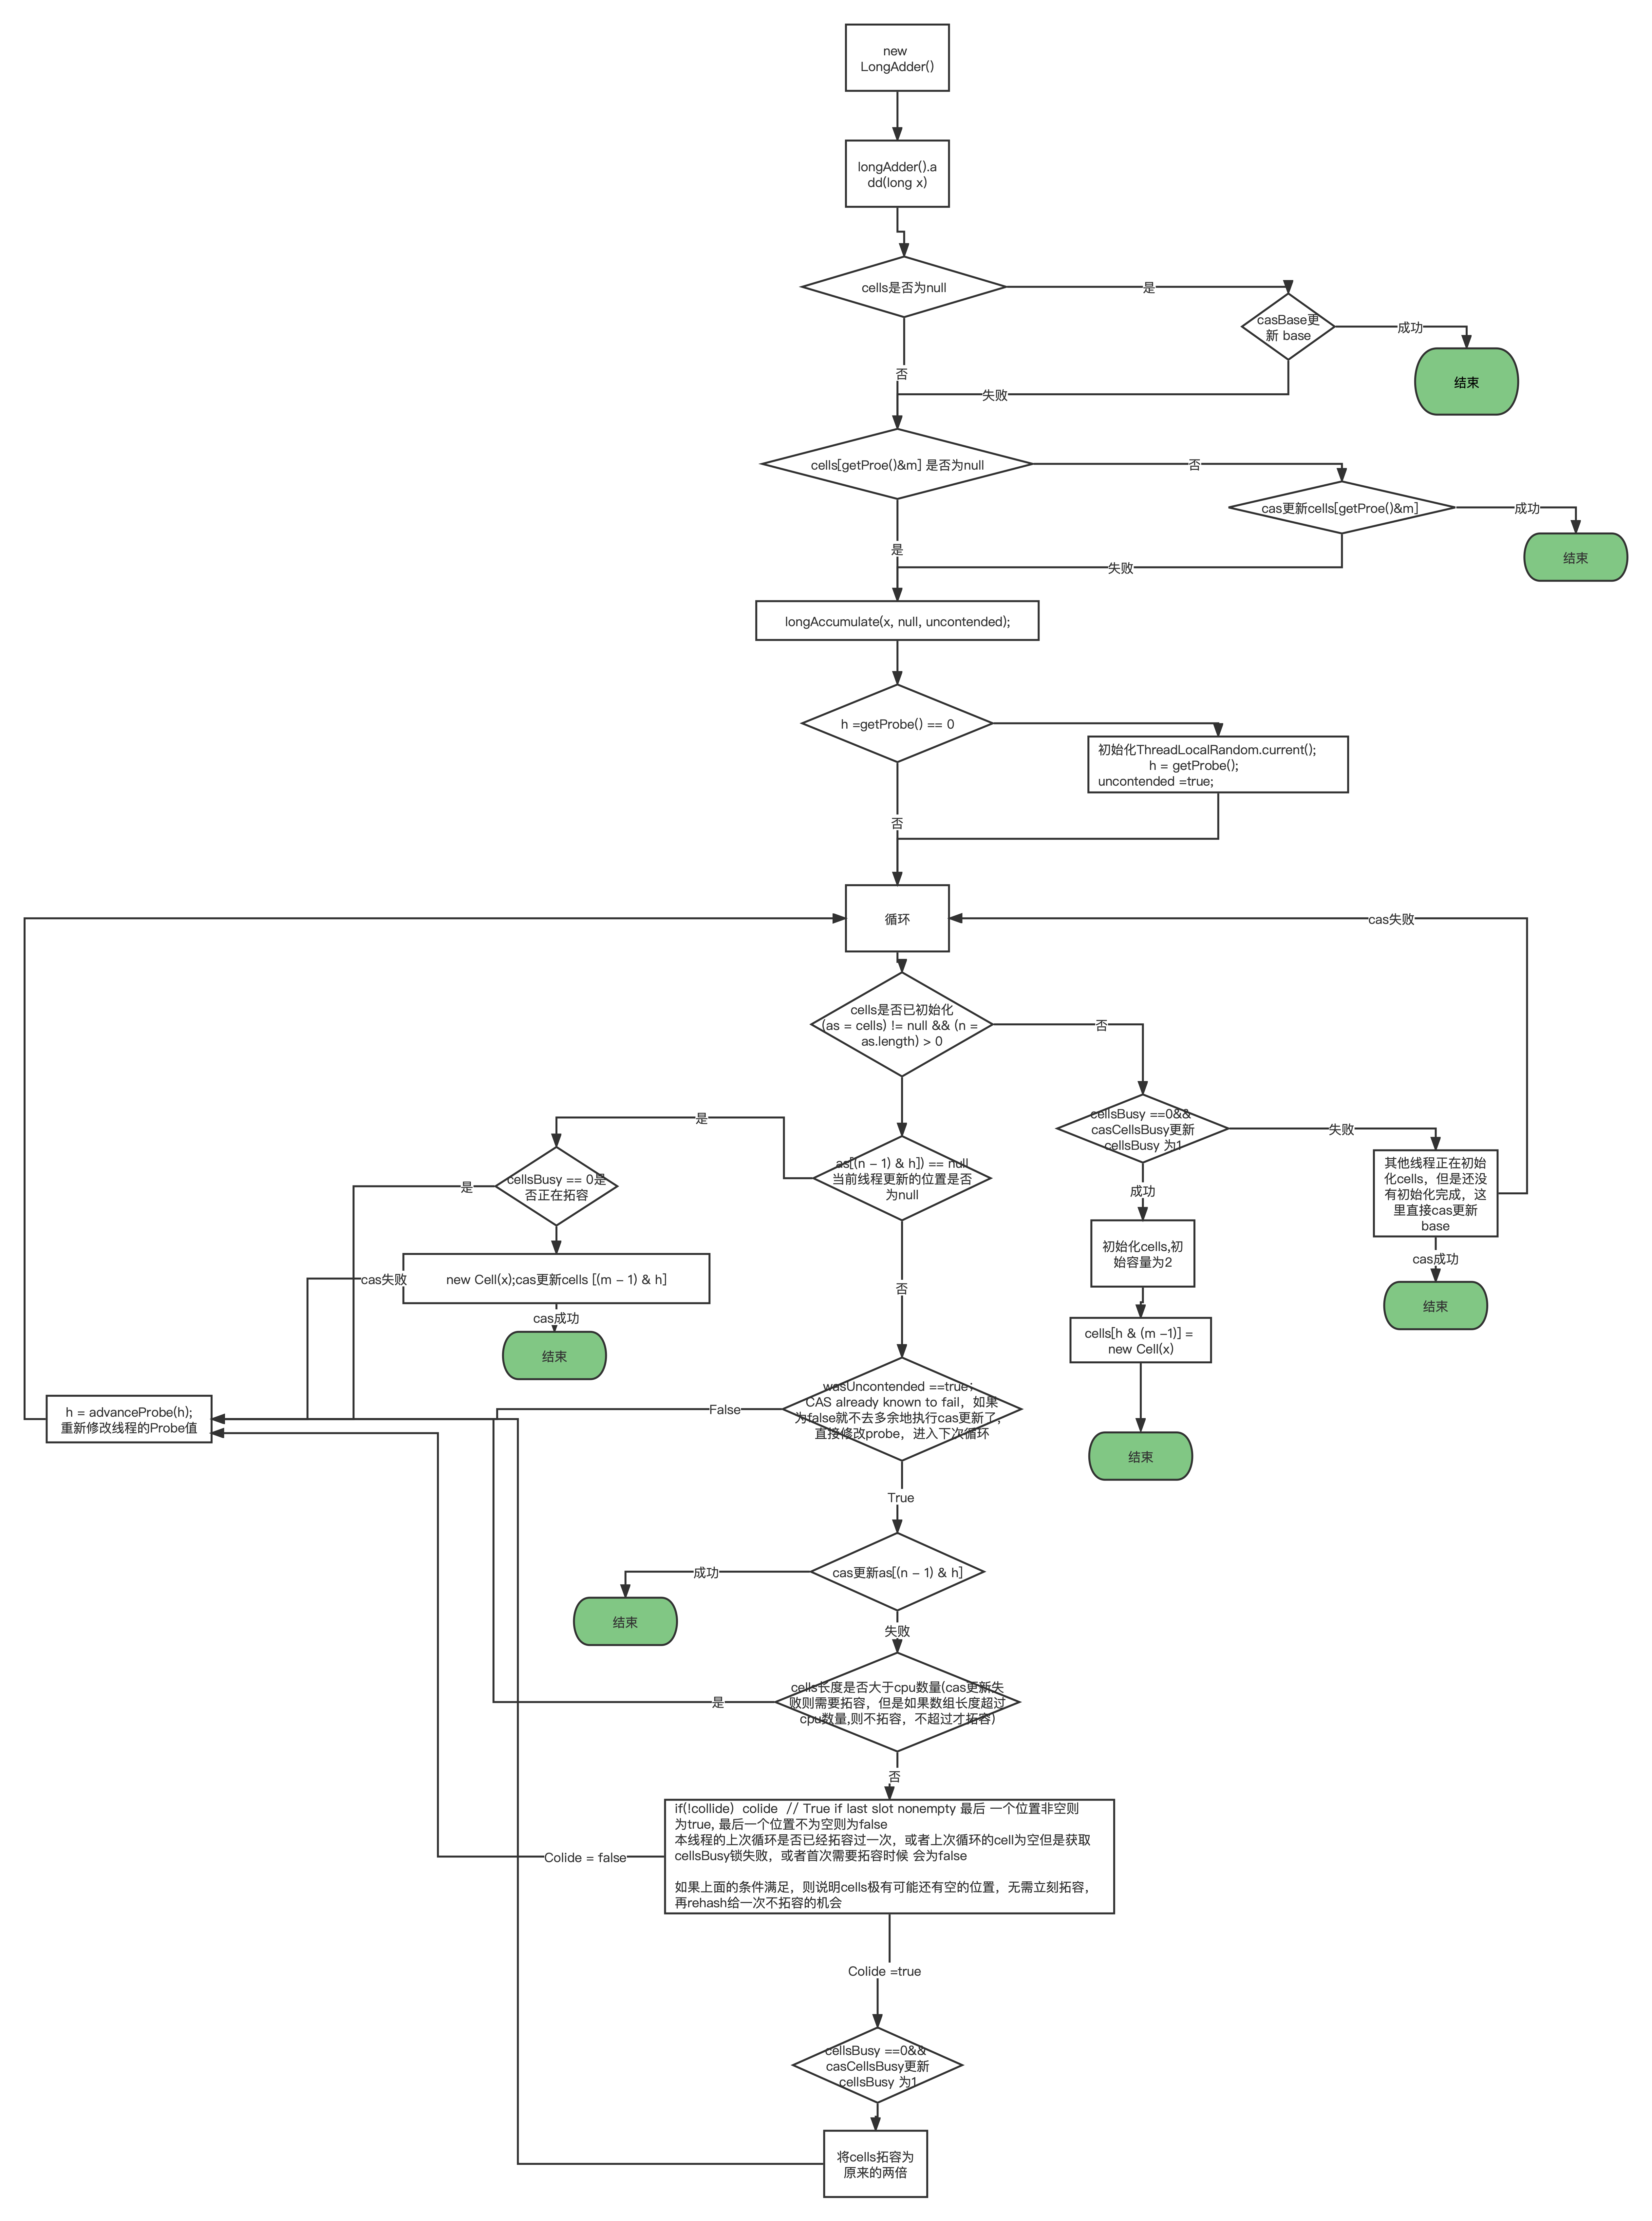
逻辑流程图:
4. 与AtomicLong对比
| 名称 | 原理 | 场景 | 缺陷 |
|---|---|---|---|
| AtomicLong | CAS + 自旋 | 低并发下的全局计算,AlomicLong能保证并发情况下计数的准确性,其内部通过CAS来解决并发安全性的问题。可允许一些性能损耗,要求高精度时可使用。AtomicLong是多个线程针对单个热点值value进行原子操作 | 高并发后性能急剧下降。(N个线程CAS操作修改线程的值,每次只有一个成功过,其它N-1失败,失败的不停的自旋直到成功,这样大量失败自旋的情况,占用大量CPU) |
| LongAdder | CAS+Base+Cell数组分散,通过空间换时间分散了热点数据 | 高并发下的全局计算,当需要在高并发下有较好的性能表现,且对值的精确度要求不高时,可以使用。LongAdder是每个线程拥有自己的槽,各个线程一般只对自己槽中的那个值进行CAS操作 | sum求和后还有计算线程修改结果的话,最后结果不够准确 |