强化学习—— Twin delay deep deterministic policy gradient(TD3算法
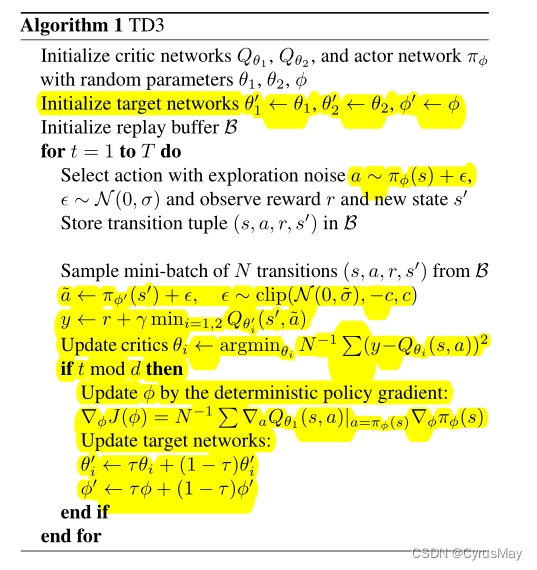
1 算法原文流程
2 算法核心技巧
2.1 累计误差
Q θ ( s t , a t ) = r t + γ ⋅ E [ Q θ ( s t + 1 , a t + 1 ) ] − δ ( s t , a t ) Q_\theta(s_t,a_t)=r_t + \gamma \cdot E[Q_\theta(s_ {t+1},a_{t+1})]-\delta(s_t,a_t) Qθ(st,at)=rt+γ⋅E[Qθ(st+1,at+1)]−δ(st,at)
展开后得到:
Q θ ( s t , a t ) = E s i ∼ p π , a i ∼ π [ ∑ i = 1 T γ i ⋅ ( r i − δ i ) ] Q_\theta(s_t,a_t)=E_{s_i \sim p_\pi ,a_i \sim \pi}[\sum_{i=1}^T \gamma_i \cdot(r_i - \delta_i)] Qθ(st,at)=Esi∼pπ,ai∼π[i=1∑Tγi⋅(ri−δi)]
所以动作价值的估计函数学习的目标是累计回报与TD error之差的期望。
2.2 clipped Double Q-learning
y 1 = r + γ ⋅ m i n i = 1 , 2 Q θ i ′ ( s ′ , π ϕ 1 ( s ′ ) ) y_1 = r+\gamma\cdot min_{i=1,2}Q_{\theta _ i^{'}}(s^{'},\pi_{\phi _1}(s^{'})) y1=r+γ⋅mini=1,2Qθi′(s′,πϕ1(s′))
- 避免高估,可能引入低估,但低估比高估要好。
2.3 Target Network
使用了两个动作价值网络和一个策略网络,对应于三个Target 网络。
Q θ 1 ← Q θ 1 ′ Q_{\theta_1}\gets Q_{\theta_1^{'}} Qθ1←Qθ1′
Q θ 2 ← Q θ 2 ′ Q_{\theta_2}\gets Q_{\theta_2^{'}} Qθ2←Qθ2′
π ϕ ← π ϕ ′ \pi_{\phi}\gets \pi_{\phi^{'}} πϕ←πϕ′
- 使用两个动作价值网络,是为了进一步降低高估
- 使用一个策略网络是为了简化计算
2.4 Delayed Policy Updates
- 策略网络在高误差状态下进行更新容易得到发散的动作
- 策略网络应该以低于价值网络更新的频率进行更新
- 直到价值网络的误差尽可能低时再更新策略网络
- TD-error较小时在对target网络的参数进行更新
2.5 Target Policy Smoothing Regularization
- 为了避免确定策略网络过度拟合窄峰值,即避免近似误差造成的不精确问题(避免增大方差)
- 相似的动作应该有相似的动作价值
y = r + γ ⋅ Q θ ′ ( s ′ , π ϕ ′ ( s ′ ) + ϵ ) y = r + \gamma \cdot Q_{\theta^{'}}(s^{'},\pi_{\phi^{'}}(s^{'})+\epsilon) y=r+γ⋅Qθ′(s′,πϕ′(s′)+ϵ)
ϵ ∼ c l i p ( N ( 0 , δ ) , − c , c ) \epsilon \sim clip(N(0,\delta),-c,c) ϵ∼clip(N(0,δ),−c,c)
3 算法计算步骤
初始化价值网络 Q θ 1 Q_{\theta_1} Qθ1、 Q θ 2 Q_{\theta_2} Qθ2,初始化策略网络 π ϕ \pi_{\phi} πϕ,并随机初始化其中的参数
初始化Target网络中的参数 θ 1 ′ ← θ 1 \theta_1^{'}\gets \theta_1 θ1′←θ1、 θ 2 ′ ← θ 2 \theta_2^{'}\gets \theta_2 θ2′←θ2、 ϕ ′ ← ϕ \phi^{'}\gets \phi ϕ′←ϕ
初始化replay buffer
for t=1 to T do:
--------选择动作并加入探索性: a ∼ π ϕ ( s ) + ϵ a\sim \pi_{\phi}(s)+\epsilon a∼πϕ(s)+ϵ 其中 ϵ ∼ N ( 0 , δ ) \epsilon \sim N(0,\delta) ϵ∼N(0,δ)
--------得到奖励 r r r,并得到下一时刻的状态 s ′ s^{'} s′
--------将transition ( s , a , r , s ′ ) (s,a,r,s^{'}) (s,a,r,s′)存入replay buffer
-------- 从replay buffer中随机采样一个batch
-------- a ^ ∼ π ϕ ′ ( s ′ ) + ϵ \hat{a}\sim \pi_{\phi^{'}}(s^{'})+\epsilon a^∼πϕ′(s′)+ϵ 其中 ϵ ∼ c l i p ( N ( 0 , δ ) , − c , c ) \epsilon \sim clip(N(0,\delta),-c,c) ϵ∼clip(N(0,δ),−c,c)
-------- y = r + γ ⋅ m i n i = 1 , 2 Q θ i ′ ( s ′ , a ^ ) y = r+\gamma\cdot min_{i=1,2}Q_{\theta _ i^{'}}(s^{'},\hat{a}) y=r+γ⋅mini=1,2Qθi′(s′,a^)
--------更新价值网络 θ i ∼ a r g m i n θ i N − 1 ∑ ( y − Q θ i ( s , a ) ) 2 \theta_i \sim argmin_{\theta_i}N^{-1}\sum{(y-Q_{\theta_i}(s,a))^2} θi∼argminθiN−1∑(y−Qθi(s,a))2
-------- if t % d then :
----------------依据确定策略梯度更新策略网络:
---------------- ▽ J ϕ ( ϕ ) = N − 1 ∑ ▽ a Q θ 1 ( s , a ) ⋅ ▽ ϕ π ϕ ( s ) \bigtriangledown J_\phi(\phi)=N^{-1}\sum\bigtriangledown_a Q_{\theta_1}(s,a)\cdot\bigtriangledown _\phi \pi_\phi(s) ▽Jϕ(ϕ)=N−1∑▽aQθ1(s,a)⋅▽ϕπϕ(s)
---------------- 更新Target network
---------------- θ 1 ′ ← τ ⋅ θ 1 + ( 1 − τ ) ⋅ θ 1 ′ \theta_1^{'}\gets \tau \cdot \theta_1 + (1-\tau)\cdot \theta_1^{'} θ1′←τ⋅θ1+(1−τ)⋅θ1′
---------------- θ 2 ′ ← τ ⋅ θ 2 + ( 1 − τ ) ⋅ θ 2 ′ \theta_2^{'}\gets \tau \cdot \theta_2 + (1-\tau)\cdot \theta_2^{'} θ2′←τ⋅θ2+(1−τ)⋅θ2′
---------------- ϕ ′ ← τ ⋅ ϕ + ( 1 − τ ) ⋅ ϕ ′ \phi^{'}\gets \tau \cdot \phi + (1-\tau)\cdot \phi^{'} ϕ′←τ⋅ϕ+(1−τ)⋅ϕ′By CyrusMay 2022.08.23